负荷预测
5.4 负荷预测
Section titled “5.4 负荷预测”本案例介绍利用MEMS实现负荷预测,包括从scada数据源获取负荷功率量测数据、Onnx神经网络计算、预测结果写入scada数据源。
负荷预测是基于历史用电数据与相关影响因素,对电力系统未来特定时段的负荷需求进行科学估计的技术。本案例中,MEMS从96个测点的当前值读入由上游预先准备好的历史负荷窗口,然后在计算链路中调用已训练好的Onnx模型节点执行推理,最后输出未来一天96个点的负荷预测功率。
负荷预测案例中,需要配置量测信息:历史窗口测点(100001-100096)按时间顺序存放过去一天的96个值,以及预测测点(200001-200096)用于保存计算后的未来一天96个点的负荷预测功率。
本例读取的是96个测点的当前快照,不会自动查询过去24小时,也不会把一个测点展开成96个时刻。应由上游按约定顺序刷新完整窗口;需要直接查历史时,使用带?id=...&start=...&end=...的Source_Meas,再处理采样间隔、缺失值和排序。
配置预测流程
Section titled “配置预测流程”在设置项-报表配置实现负荷预测计算的DataFrame流,包括获取历史负荷功率数据、onnx计算、预测结果输出等,先将流程65541设为手动触发、Memory保存,确认未与已有ID冲突。除下面的源节点1、4和计算节点5外,节点2、3、6均配置为None,分别接收唯一输入。以下为配置片段,导入时按七列补齐详情、节点、边三个块。
(1)获取历史负荷功率数据
Section titled “(1)获取历史负荷功率数据”报表配置文件中,在节点1中获取历史负荷功率数据(即value量测值),如下所示:
| DFF ID | 节点ID | 名称 | 节点类型 | 参数1 | 参数2 |
|---|---|---|---|---|---|
| 65541 | 1 | input_value | Source_Meas | select value from meas where id between 100001 and 100096 order by id asc |
节点1类型为Source_Meas,表示获取量测表信息。参数2中的sql语句含义:获取来源0中ID为100001至100096的当前值,并按ID排序。必须检查恰有96行、没有缺失/NaN,且点号顺序就是模型约定的时间顺序;不能只凭ID范围认定窗口完整。
(2)onnx计算
Section titled “(2)onnx计算”1)数据预处理
Section titled “1)数据预处理”获取历史负荷功率数据后,在边1(节点1→节点2)中对数据进行预处理,以匹配onnx文件的输入数据格式,如下所示:
| DFF ID | 首尾节点 | 动作名称 | 描述 | 动作类型 | 参数1 | 参数2 |
|---|---|---|---|---|---|---|
| 65541 | 1;2 | 预处理 | Eval | select(alias(cast(col(value),f32),value_1_1_96)); |
边1类型为Eval,表示将名为value的数据进行强制类型转换为f32类型,并改名为value_1_1_96。
2)Onnx计算
Section titled “2)Onnx计算”数据预处理后,在边2(节点2→节点3)中执行神经网络计算动作,如下所示:
| DFF ID | 首尾节点 | 动作名称 | 描述 | 动作类型 | 参数1 | 参数2 |
|---|---|---|---|---|---|---|
| 65541 | 2;3 | 负荷预测 | Onnx | D:\Users\Downloads\负荷预测案例\model_96_96.onnx |
边2类型为Onnx,将节点2输入的数据作为神经网络输入,经过model_96_96.onnx后输出数据至节点3。(注意:该动作参数是保存model_96_96.onnx文件的路径,下载案例后需要修改为实际的文件路径)。
(3)预测结果写入scada数据源
Section titled “(3)预测结果写入scada数据源”该单输出模型的推理结果是名为mat_1_1_96的一列DataFrame,96个元素按列保存;列名携带张量形状1×1×96,而写入scada数据源的DataFrame需包含“point”和“analog”两列信息,因此需要数据处理,具体如下:
1)获取目标测点ID
Section titled “1)获取目标测点ID”测点配置中,已配置ID为200001-200096的测点用于保存计算后的未来一天96个点的负荷预测功率,用Source_Points读取已配置的目标测点ID,如下所示:
| DFF ID | 节点ID | 名称 | 节点类型 | 参数1 | 参数2 |
|---|---|---|---|---|---|
| 65541 | 4 | input_pointID | Source_Points | select id from points where id between 200001 and 200096 order by id asc |
节点4从测点配置表读取ID,不依赖这些目标点已收到现场量测。检查得到96行,并按相同顺序与96个预测值对应。
然后,通过类型为Eval的边3(节点4→节点5)对获取的张量改名,如下所示:
| DFF ID | 首尾节点 | 动作名称 | 描述 | 动作类型 | 参数1 | 参数2 |
|---|---|---|---|---|---|---|
| 65541 | 4;5 | output_pointID | Eval | select(alias(col(id), point)); |
2)Onnx预测结果数据处理
Section titled “2)Onnx预测结果数据处理”| DFF ID | 首尾节点 | 动作名称 | 描述 | 动作类型 | 参数1 | 参数2 |
|---|---|---|---|---|---|---|
| 65541 | 3;5 | prediction_value | Eval | select(alias(col(mat_1_1_96), analog)); |
边4(节点3→节点5)类型为Eval,表示将名为mat_1_1_96的张量改名为analog。
3)数据拼接
Section titled “3)数据拼接”| DFF ID | 节点ID | 名称 | 节点类型 | 参数1 | 参数2 |
|---|---|---|---|---|---|
| 65541 | 5 | 准备输出预测结果 | TensorEval | prediction_meas = concat(horizontal, output_pointID,prediction_value); | 4 |
节点5类型为TensorEval,通过concat函数将output_pointID、prediction_value两张DataFrame按行水平拼接为含point/analog的表。
4)数据写入scada数据源
Section titled “4)数据写入scada数据源”| DFF ID | 首尾节点 | 动作名称 | 描述 | 动作类型 | 参数1 | 参数2 |
|---|---|---|---|---|---|---|
| 65541 | 5;6 | 结果写入scada数据源 | WriteFile | meas://0 |
边5(节点5→节点6)类型为WriteFile,表示将结果写入scada数据源的指定测点中。
模型的采样间隔、功率单位、归一化与反归一化应按训练合同执行。本例预处理仅做f32转换和列名设置,不自动实现这些步骤。
解压附件,导入历史窗口与预测结果测点,将预测点设为允许本地赋值的点,并提交、应用测点
版本。先向历史窗口96个点写入完整输入,再导入报表并修改ONNX模型路径。保存并加载流程后,
到事件-策略启动系统,手动运行DFF 65541。在仪表盘-报表选择这次执行记录,应用表格模板:
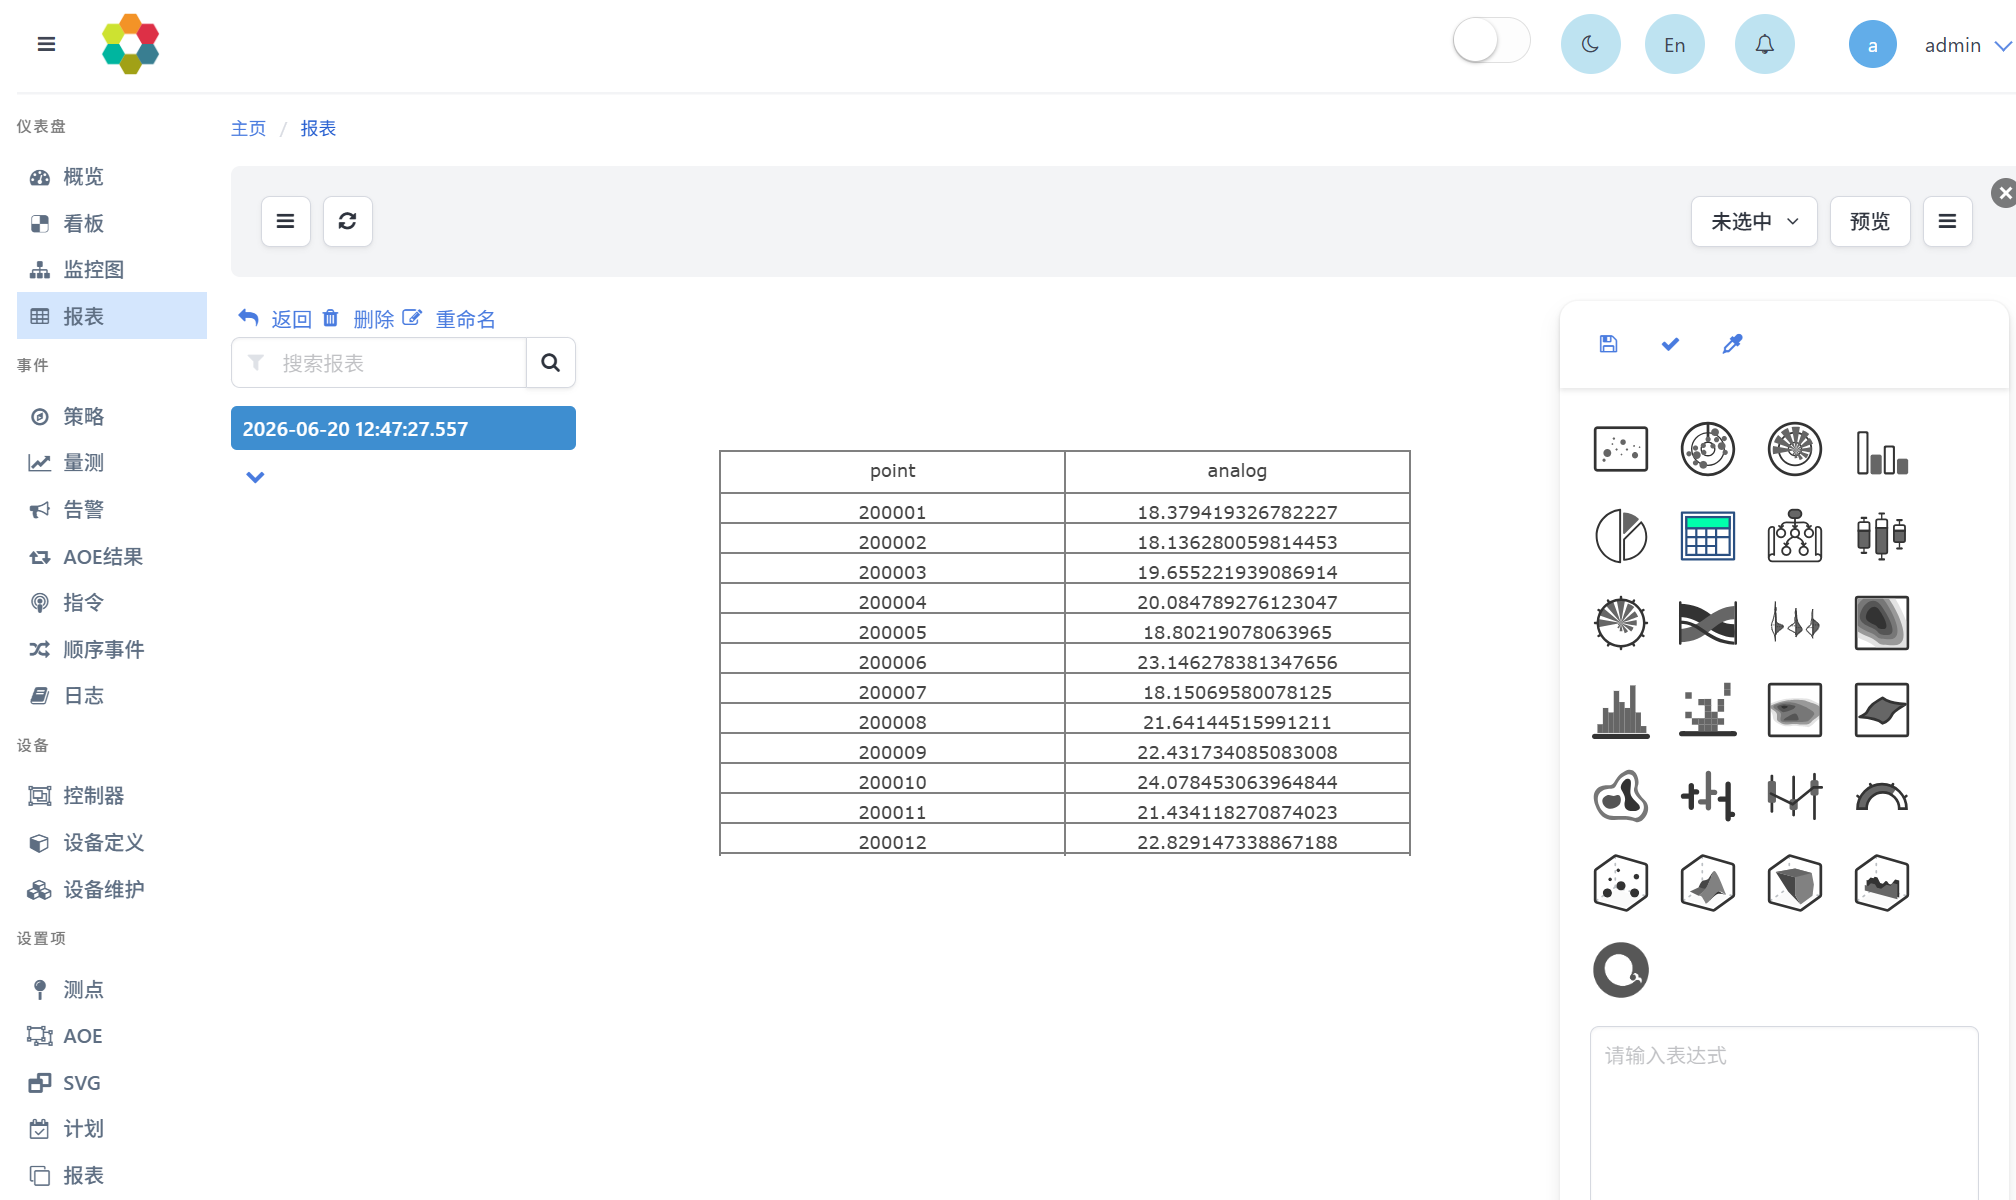
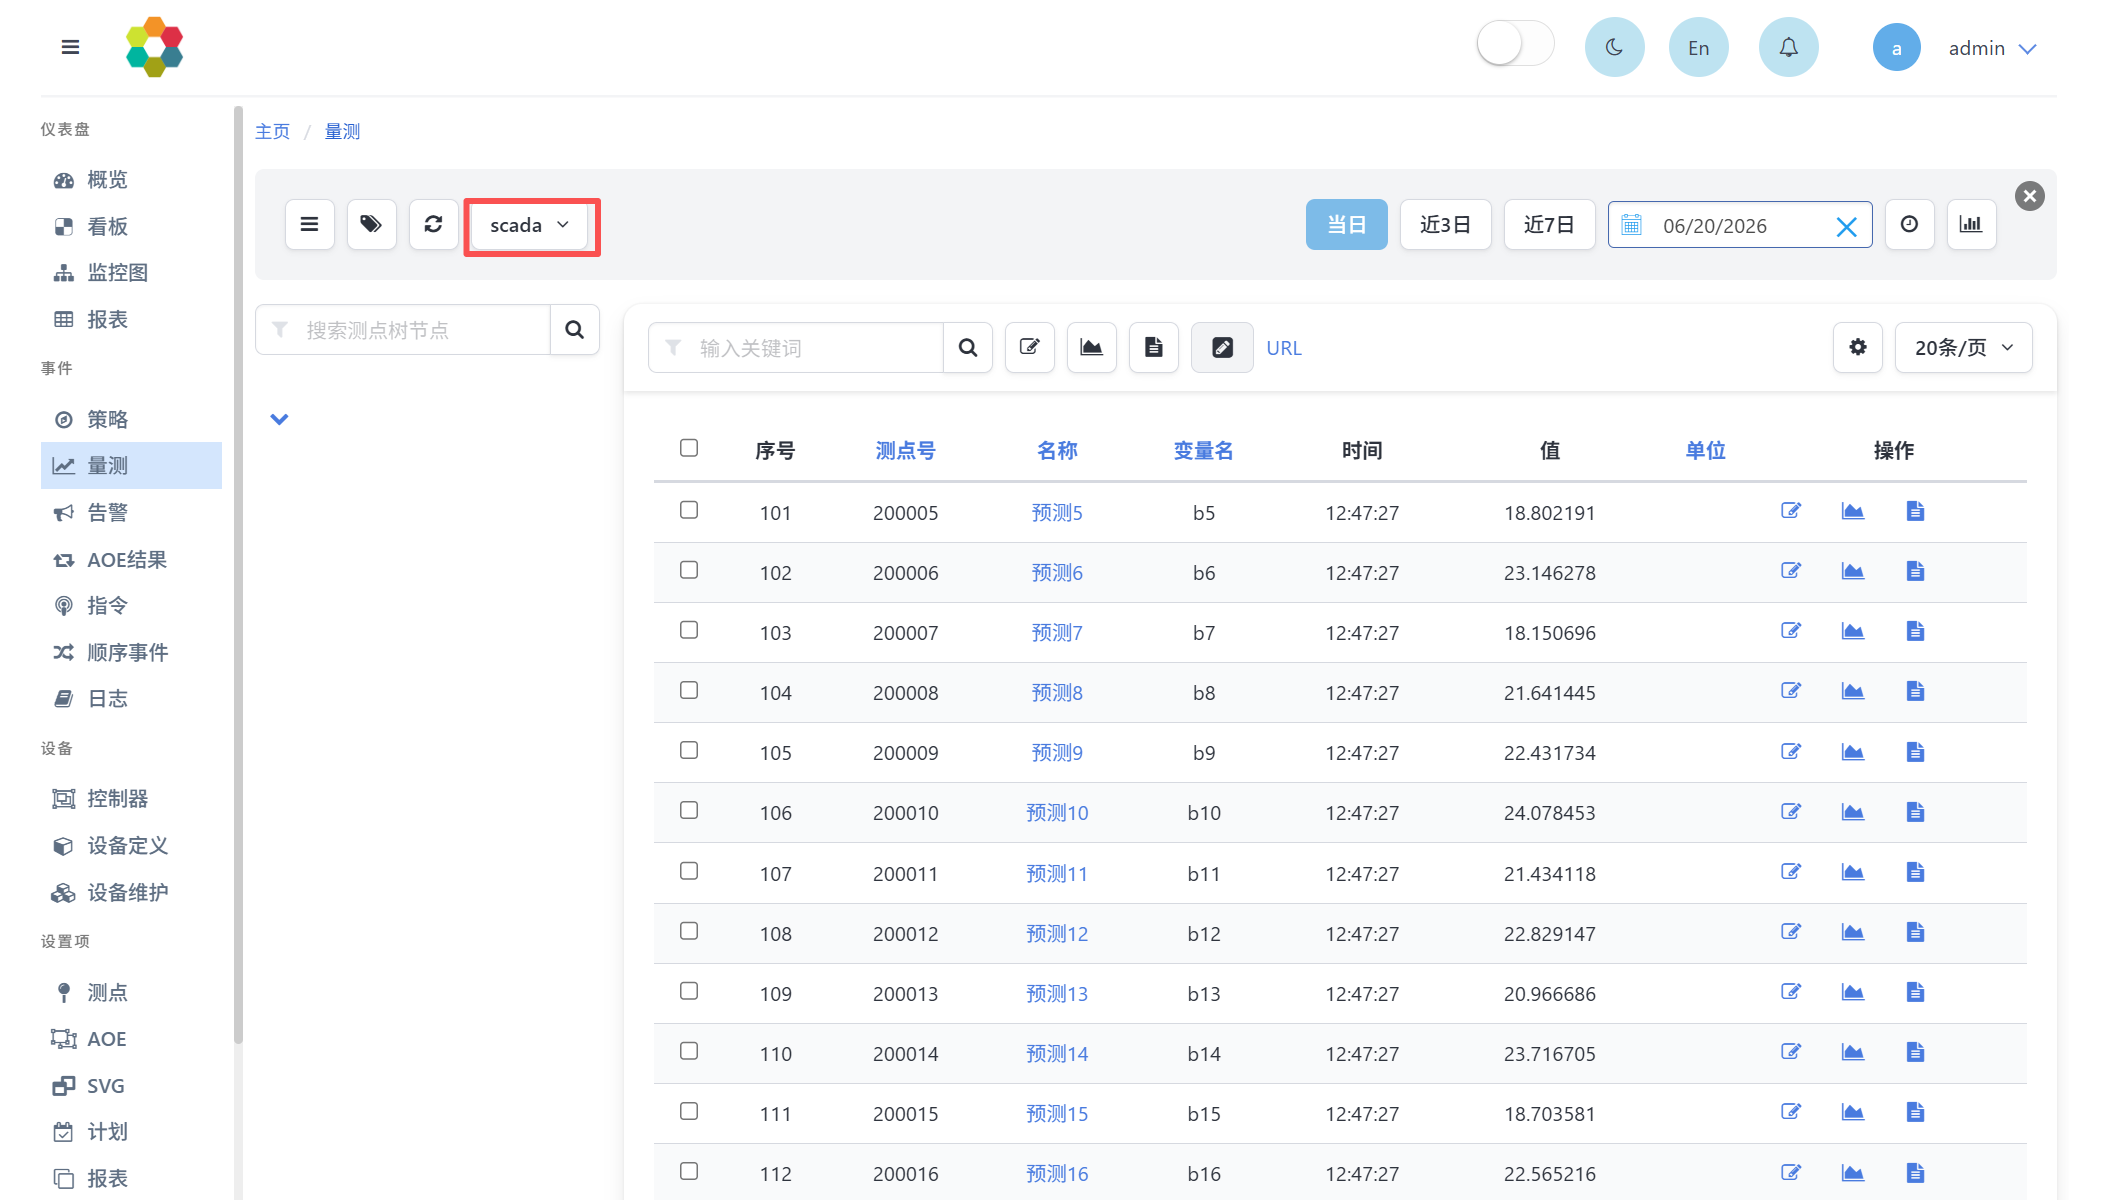
也可在事件-量测页面中选择scada数据源。可查询测点量测值,如下图所示:
以下附件中提供了上述负荷预测的DataFrame流的配置文件,可参考使用。
附件:负荷预测案例.zip
这里用96个测点的当前值拼出一个已准备好的历史窗口,不是直接查询一个测点过去一天的
时间序列。使用Source_Meas查询实时表时应指定正确来源并保证恰好96行、无null/NaN,
排序规则与训练模型一致。value_1_1_96维度乘积必须等于单列元素数,dtype应为模型要求的f32。
本地ONNX模型从服务进程的工作目录解析;带外部权重的模型要保留其相对目录结构。
Onnx的URL可在导入阶段下载,OnnxUrl则在执行时下载。当前边按单张量输入并取推理结果中的
最后一个输出,不代表通用多输入/多输出ONNX服务。
节点2、3、6应是已定义的透传/终端节点,最终把测点号和预测值按相同顺序水平拼接。
meas://0目标应为允许本地赋值的预测测点;写回不等同于直接控制远端设备。
使用附件配置时,将详情、节点和边的流程ID统一为未占用的≥65536值,并按本机部署修改路径。